


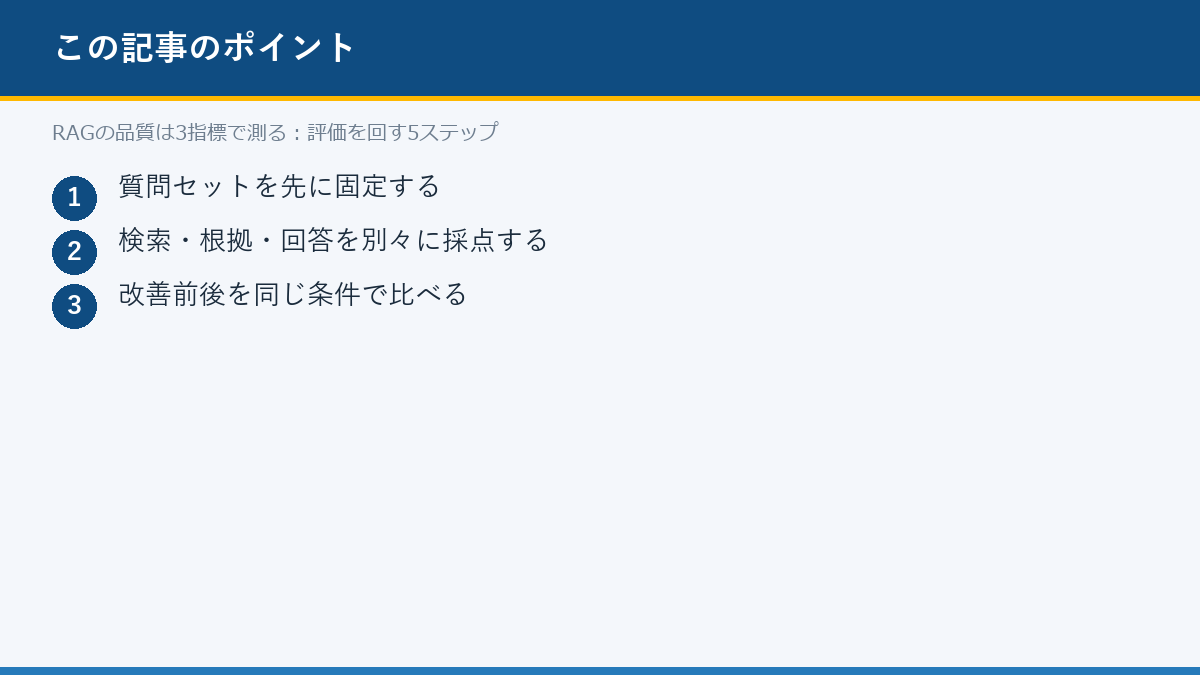
RAG を組むと、回答が良くなった気はしても、どこが良くなったのか分からないままになりがちです。DeepLearning.AI の講座「Building and Evaluating Advanced RAG」は、評価の枠組みとして RAG triad を提示しています。Context Relevance、Groundedness、Answer Relevance の3つを分けて測ると、直す場所がはっきりします。
ステップ1:質問セットを30問つくる
評価の土台は、実際に聞かれる質問の集合です。現場で受けた質問から、答えが資料に書かれているもの、書かれていないもの、複数の資料をまたぐものを混ぜて30問ほど用意します。資料にない質問を入れるのは、答えられないときに「分からない」と言えるかを見るためです。
各質問には、期待する答えの要点と、根拠になる箇所を1行で添えます。ここが曖昧だと、採点のたびに判断がぶれます。
ステップ2:Context Relevance(検索の適合)を測る
質問に対して、検索が返した文脈がどれだけ関係しているかを見ます。回答は見ず、検索結果だけを判定します。無関係な文書が混ざっていれば、この指標が下がります。
下がった場合に疑うのは、分割の粒度、検索方式、フィルタの設定です。回答文を直しても改善しません。
ステップ3:Groundedness(根拠への忠実さ)を測る
回答の各記述が、渡した文脈に支えられているかを見ます。文脈にない断定や、数値の取り違えがあれば、ここで検出します。
下がった場合に疑うのは、指示文の縛りの弱さです。「渡した文脈にない情報は書かない」「不明な点は不明と書く」といった条件が入っているかを確認します。
ステップ4:Answer Relevance(質問への適合)を測る
回答が、質問に対して過不足なく答えているかを見ます。根拠に忠実でも、質問の論点を外していれば価値は下がります。長すぎる前置きや、聞かれていない周辺説明もここで減点されます。
| 指標 | 見る対象 | 下がったときに直す場所 |
|---|---|---|
| Context Relevance | 検索結果 | 分割、検索方式、絞り込み条件 |
| Groundedness | 回答と根拠の対応 | 指示文の制約、引用の指定 |
| Answer Relevance | 回答と質問の対応 | 出力形式、聞くべき論点の指定 |
ステップ5:記録して、同じ条件で比べる
3指標の結果を、質問ごとに表へ残します。改善を入れたら、同じ質問セットを同じ条件で流し、変化を見ます。平均点だけでなく、どの質問が改善し、どの質問が悪化したかまで記録します。
改善の順序は、検索、指示、モデルの順が現実的です。検索が外れている状態で指示文を練っても、渡される材料が変わらないため効果は限られます。
つまずきポイント
- 質問セットを作らずに始める:毎回違う質問で試すと、改善したかを判断できません。
- 3指標を1つにまとめる:合計点だけを見ると、どの工程が原因か分からなくなります。
- モデルを替えて誤魔化す:検索の不備はモデルを替えても残ります。
FAQ
Q. 3指標のどれか1つだけ見れば足りますか?
A. 足りません。検索が外れているのか、根拠から外れているのか、質問に答えていないのかで、直す場所が変わります。
Q. 評価は何人で付ける必要がありますか?
A. 人数より、同じ基準で付け続けることが重要です。判定基準を文章にし、必要ならモデルによる一次判定と人の確認を組み合わせます。
あわせて使いたいツール
出典
出典:DeepLearning.AI「Building and Evaluating Advanced RAG」(2026年11月13日参照)。3指標の名称と評価の枠組みは同講座の公開情報に基づきます。
関連ガイド
最新のAI情報をメールで受け取る
新着のAIツール比較・ランキング・ニュースを、まとめてお届けします。
ご登録後、確認メールをお送りします。配信停止はいつでも可能です。