

問い合わせを「緊急」と「通常」に振り分けさせると、明らかに緊急でないものまで緊急に寄ることがあります。モデルが弱いのではなく、出力の分布が片側に傾いているためです。傾きは測れます。測らずに直すと、直ったかどうかも分かりません。
手順1:分類の課題と2つのラベルを決める
判定させたい分類を1つ選び、ラベルを2つに絞ります。緊急と通常、対象と対象外、といった形です。ラベルが3つ以上あると、偏りの向きが読みにくくなります。
選んだ分類について、正解がはっきりしている例を20件用意します。後の再測定で同じ20件を使うため、記録して残します。
手順2:中身のない入力を10通り作る
文脈の手がかりがない入力を10通り用意します。「なし」「該当なし」「N/A」「(空欄)」など、意味を持たない文字列です。Learn Promptingの解説も、こうした入力を用いて偏りを測る方法を説明しています。
この入力には正解がありません。どちらのラベルも同程度に返るのが期待される動きで、偏っていれば差が出ます。
手順3:返ってきたラベルを数える
10通りの入力それぞれに、ラベルを付けさせます。確率を扱える環境なら、2つのラベルの確率を記録します。扱えない環境なら、同じ入力を20回ずつ繰り返し、回数の多い側を偏りとみなします。
| 段階 | 行うこと | 記録するもの |
|---|---|---|
| 測定 | 中身のない入力にラベルを付けさせる | ラベルの内訳、確率 |
| 補正 | 両方のラベルの見本を足して依頼文を直す | 変更前後の依頼文 |
| 再測定 | 同じ入力と同じ20件で測り直す | 補正前後の差 |
手順4:両方のラベルの見本を足して補正する
偏りが確認できたら、依頼文にラベルの見本を足します。偏っている側だけでなく、両方のラベルに同じだけ割り当てます。片側だけ足すと、偏りが逆に振れます。
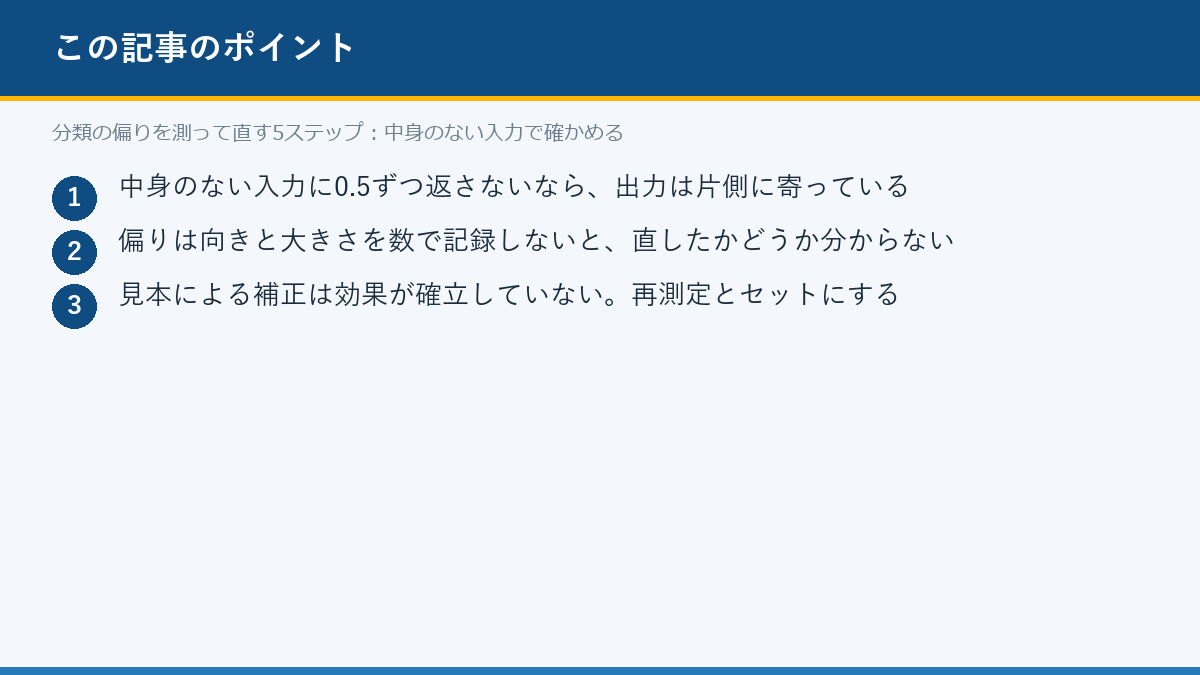
解説は、この見本による方法について、研究で効果が確かめられているわけではないと明記しています。手軽な代わりに、効き目は測って判断するしかありません。確率そのものを調整する方法は、出力の確率を扱える環境が別に必要になります。
手順5:同じ条件で測り直し、差を記録する
補正した依頼文で、手順2の10通りと手順1の20件を測り直します。中身のない入力の偏りが縮み、かつ20件の正解率が落ちていないことを確認します。片方だけを見ると、判断を誤ります。
偏りを消すために判定を鈍らせると、実データの取りこぼしが増えます。両方を並べて比べる形にしておくと、この取引を見落とさずに済みます。分類の評価を続ける方法はLLM-as-a-Judgeのページで扱っています。
FAQ
Q. 中身のない入力を与えるのはなぜですか。
A. Learn Promptingの解説は、文脈の手がかりがない入力に対しては、どちらのラベルも0.5程度になるのが期待される動きだと説明しています。実際には0.9と0.1のように偏ることがあり、その差が出力の偏りを示す目安になります。
Q. 見本を入れれば偏りは必ず直りますか。
A. 解説は、両方のラベルに割り当てた見本を入れる方法を挙げつつ、この方法が研究で確かめられているわけではないと明記しています。効果を前提にせず、同じ入力で測り直して確かめる必要があります。
あわせて使いたいツール
測定には、同じ依頼文を繰り返し投げられる環境が向きます。料金と提供条件は各サービスの公式情報で確認してください。
出典
出典:Learn Prompting「LLMの較正(出力分布の偏りを補正する)」(最終更新2024年8月7日、Sander Schulhoff著)。文脈のない入力に0.5ずつ返すのが期待される動きであること、実際には偏りが出ること、両方のラベルに割り当てた見本で補正する方法とその効果が未確立である旨は同ページの記載に基づきます。
関連ガイド
- Self-RAGで「検索すべきか」をモデルに判断させる5ステップ
- Corrective RAGで検索結果の信頼度を3段階に分ける5ステップ
- 用語:LLM-as-a-Judge(LLMによる評価)
- 検索結果を3段階で評価する練習ドリル
- 検索の要否と根拠を判定させるプロンプト見本
最新のAI情報をメールで受け取る
新着のAIツール比較・ランキング・ニュースを、まとめてお届けします。
ご登録後、確認メールをお送りします。配信停止はいつでも可能です。